Joint Probability - 联合概率
本页目录
随机向量(Random Vector):n 元随机向量 (X_{1},X_{2},\dots{},X_n),就是一个函数
\Omega \to{}\mathbb{R}^{n}
\omega \in \Omega \mapsto{}(X_{1}(\omega ),X_{2}(\omega ),\dots{},X_n(\omega ))
对于随机向量,它有:
- Joint CDF / PMF / PDF;
- Marginal CDF / PMF / PDF;
- Conditional PMF / PDF
记号:我们说 X_{1},X_{2}, \dots , X_{n} \overset{\text{i.i.d.}}{\sim} D,若 X_{1},X_{2}, \dots,X_{n} 是相互独立的且服从相同的分布 D(Independent and identically distributed, i.i.d)。
高斯积分:
\int_{-\infty}^{\infty} e^{-\frac{(x-\mu)^{2}}{2\sigma ^{2}}} \,\mathrm{d}x=\sqrt{2\pi} \sigma
Joint CDF / PMF / PDF
Joint CDF: 二元随机向量 (X,Y) 的 CDF 定义为
F(x,y)=P(X\leq{}x,Y\leq{}y )
这就叫 X 和 Y 的 joint CDF。这里可以用它来计算一个区域内的概率:
P\{ x_{1}<X\leq{}x_{2},y_{1}<Y\leq{}y_{2} \}=F(x_{2},y_{2})-F(x_{1},y_{2})-F(x_{2},y_{1})+F(x_{1},y_{1})
Marginal CDF: 若 F(x,y) 是 (X,Y) 的 joint CDF,我们说 X,Y 的 marginal CDF 是
F_{X}(x)=F(x,\infty ), F_Y(y)=F(\infty ,y)
对于离散随机向量,joint PMF:
p_{ij}\triangleq{}p(x_{i},y_{j})=P(X=x_{i},Y=y_{j})
X,Y 的 marginal PMF:
p_{X}(x_{i})=P(X=x_{i})=\sum _{j=1}^{\infty }p_{ij}\triangleq p_{i\cdot }
p_{Y}(y_{j})=P(Y=y_{j})=\sum _{i=1}^{\infty }p_{ij}\triangleq p_{\cdot j}
这些画一个表格来看就很清楚了。
Joint PDF: 对连续随机向量 (X,Y),对任意 D\subseteq \mathbb{R} ^{2}:
P((X,Y)\in D)=\iint_{(x,y)\in D} f(x,y)\,\mathrm{d}x\mathrm{d}y
则 f(x,y) 称为 joint PDF。特别的,它与 joint CDF 的关系为:
F(x,y)=\int _{-\infty }^{y}\int _{-\infty }^{x} f(u,v)\,\mathrm{d}u\,\mathrm{d}v
可以用曲面图(Surface plot)或等高线图(Contour plot)来表示 joint PDF。
Marginal PDF: 对连续随机向量 (X,Y),X,Y 的 marginal PDF:
f_{X}(x)=\int_{-\infty}^{\infty} f(x,y)\,\mathrm{d}y
f_{Y}(y)=\int_{-\infty}^{\infty} f(x,y)\,\mathrm{d}x
这里,joint PDF 可以定义 marginal PDF(通过 CDF 的求导),而反过来不行。
Conditional PMF / PDF
对离散随机向量 (X,Y) 在 Y=y 的条件下,其 joint PMF 为 p(x,y),那么 X 的 conditional PMF 定义为
p_{X\mid Y}(x\mid y)\triangleq{}P(X=x\mid Y=y)= \frac{p(x,y)}{p_{Y}(y)}
这里要求 p_{Y}(y)>0。
类似的对连续随机变量,我们有 conditional PDF:
f_{X\mid Y}(x\mid y)\triangleq{}\frac{f(x,y)}{f_{Y}(y)}
这里要求 f_{Y}(y)>0。
利用这个定义,我们有 X 的 marginal PDF 的一种求法:
f_{X}(x)= \int _{-\infty}^{\infty}f(x,y)\,\mathrm{d}y=\int_{-\infty}^{\infty} f_{X\mid Y}(x\mid y)f_{Y}(y)\,\mathrm{d}y
这也就是连续情况下的全概率公式。回忆离散情况:
p_{X}(x)=\sum _{j=1}^{\infty }p(x,y_{j})= \sum _{j=1}^{\infty} p_{X\mid Y}(x\mid y_{j})p_{Y}(y_{j})
独立性与协方差
利用 Joint CDF 重新定义独立性。 若 (X_{1},X_{2},\dots,X_{n}) 有 joint CDF F,那么我们说 X_{1},X_{2},\dots,X_{n} 相互独立,当
F(x_{1},x_{2},\dots,x_{n})=F_{X_{1}}(x_{1})F_{X_{2}}(x_{2})\dots F_{X_{n}}(x_{n})
推论:若离散随机变量 X_{1},X_{2},\dots,X_{n} 相互独立,那么
p(x_{1},x_{2},\dots,x_{n})=p_{X_{1}}(x_{1})p_{X_{2}}(x_{2})\dots p_{X_{n}}(x_{n})
若连续随机变量 X_{1},X_{2},\dots,X_{n} 相互独立,那么下式几乎处处成立(反之也成立):
f(x_{1},x_{2},\dots,x_{n})=f_{X_{1}}(x_{1})f_{X_{2}}(x_{2})\dots f_{X_{n}}(x_{n})
几乎处处(a.e.):除一个零测集之外成立(二维时就是面积为 0 的集合)。PDF 在零测集上的取值不影响概率。
要说明 X,Y 不独立,单点不满足乘积分解一般不够;证明 f(x,y)\neq f_{X}(x)f_{Y}(y) 在一个面积非零的集合上成立即可,不一定要算积分。也可以找一个区域 D,使得
\iint_{D} f(x,y)\,\mathrm{d}x\mathrm{d}y\neq\iint_{D} f_{X}(x)f_{Y}(y)\,\mathrm{d}x\mathrm{d}y
若两边的密度在该点附近连续,单点不等就能推出一个邻域内不等,因此也可以判断不独立。
若 X,Y 是相互独立的,那么对任意函数 g 和 h,有
\mathrm{E}(g(X)h(Y))=\mathrm{E}(g(X))\mathrm{E}(h(Y))
\operatorname{Var}(g(X)\pm h(Y))=\operatorname{Var}(g(X))+\operatorname{Var}(h(Y))
特例:对独立的 X,Y,有 \mathrm{E}(XY)=\mathrm{E}(X)\mathrm{E}(Y), \operatorname{Var}(X+Y)=\operatorname{Var}(X)+\operatorname{Var}(Y)。
注意到对一般的随机变量 X,Y,
\operatorname{Var}(X+Y)-\operatorname{Var}(X)-\operatorname{Var}(Y)=2\mathrm{E}((X-\mathrm{E}(X))(Y-\mathrm{E}(Y)))
我们定义随机变量 X 与 Y 协方差(Covariance) 为
\operatorname{Cov}(X, Y)\triangleq \mathrm{E}((X-\mathrm{E}(X))(Y-\mathrm{E}(Y)))=\mathrm{E}(XY)-\mathrm{E}(X)\mathrm{E}(Y)
这刻画了 X,Y 的线性相关性。
- 若
X,Y独立,那么\operatorname{Cov}(X, Y)=0。 - 若
\operatorname{Cov}(X, Y)=0,那么X,Y不一定独立。我们说它们 不相关(Uncorrelated)。 - 这是因为,不相关的随机变量仍可能存在非线性关系,因此不一定独立。
- 若
\operatorname{Cov}(X, Y)>0,我们说X,Y正相关。 - 若
\operatorname{Cov}(X, Y)<0,我们说X,Y负相关。
有如下的性质:
\operatorname{Cov}(X, X)=\operatorname{Var}(X)\operatorname{Var}(X\pm Y)=\operatorname{Var}(X)+\operatorname{Var}(Y)\pm 2\operatorname{Cov}(X, Y)\operatorname{Cov}(X, Y)=\operatorname{Cov}(Y, X)\operatorname{Cov}(X, c)=0,其中c为常数\operatorname{Cov}(aX, bY)=ab\operatorname{Cov}(X, Y)\operatorname{Cov}(X_{1}+X_{2}, Y)=\operatorname{Cov}(X_{1}, Y)+\operatorname{Cov}(X_{2}, Y)
Bilinear Property:
\operatorname{Cov}\left( \sum_i a_{i}X_{i}, \sum_j b_{j}Y_{j}\right)=\sum_i \sum_j a_{i} b_{j}\operatorname{Cov}(X_{i},Y_{j} )
相关系数
由此定义相关系数(Correlation Coefficient):
\rho _{XY}=\operatorname{Cor}(X, Y)\triangleq \mathrm{E}\left( \frac{X-\mathrm{E}(X)}{\operatorname{SD}(X)}\cdot \frac{Y-\mathrm{E}(Y)}{\operatorname{SD}(Y)} \right) = \frac{\operatorname{Cov}(X, Y)}{\sqrt{\operatorname{Var}(X)\operatorname{Var}(Y)}}
这衡量了 Y 与 X 之间线性相关性的强度。0\leq\lvert \rho \rvert\leq1,且 \lvert \rho \rvert 越大,线性相关性就越强;\rho 为正的时候是正相关,为负的时候是负相关。
- 考虑
\hat{Y}=aX+b,那么可以推导出\min _{a,b}\text{MSE}=\operatorname{Var}(Y)(1-\rho _{XY}^{2}),其中\text{MSE}表示均方误差。于是\lvert \rho \rvert越大表示均方误差的最小值越小,也就是线性预测的准确度越高。 - 这个推导也可以证明
\rho的范围。
条件期望
对于离散随机向量 (X,Y),定义
\mathrm{E}(X\mid Y=y)\triangleq \sum _{k=1}^{\infty}x_{k}\cdot P(X=x_{k}\mid Y=y)
类似的,对于连续的情况:
\mathrm{E}(X\mid Y=y)\triangleq\int_{-\infty}^{\infty} xf_{X\mid Y}(x\mid y)\,\mathrm{d}x
这里会发现,给定 Y=y 下 X 的期望 \mathrm{E}(X\mid Y=y)是一个 y 的函数。那么有如下记号:
\mathrm{E}(X\mid Y)= g(Y)
这是一个随机变量。
当 X,Y 相互独立的时候,有
\mathrm{E}(X\mid Y)=\mathrm{E}(X)
不依赖于 Y。
全期望公式(Law of Total Expectation):
\mathrm{E}(X)=\mathrm{E}(\mathrm{E}(X\mid Y))
这是因为,以离散情况为例:
\mathrm{E}(X)=\sum _{j} \mathrm{E}(X\mid Y=y_{j})P(Y=y_{j})
多随机变量的变换
若连续随机变量 Z=g(X,Y),则 z 的 CDF 可以这样去求:
F_{Z}(z)=P(g(X,Y)\leq z)= \iint _{g(x,y)\leq z} f(x,y)\,\mathrm{d}x \mathrm{d}y
随机变量之和
若 Z=X+Y,有如下结论,可以直接算出 PDF:
f_{Z}(z)= \int_{-\infty}^{\infty} f(x,z-x)\,\mathrm{d}x
特别的,若 X,Y 相互独立:
f_{Z}(z)=f_{X}*f_{Y}=\int_{-\infty}^{\infty} f_{X}(x)f_{Y}(z-x)\,\mathrm{d}x=\int_{-\infty}^{\infty} f_{X}(z-y)f_{Y}(y)\,\mathrm{d}y
这里 f_{X}*f_{Y} 称为 f_{X} 与 f_{Y} 的卷积(Convolution)。
离散的情况也类似。若 X,Y 相互独立且取非负整数值,可以用离散卷积:
p_{Z}(k)= \sum _{i=0}^{k}P(X=i)P(Y=k-i)=\sum _{j=0}^{k}P(X=k-j)P(Y=j)
例如,若 T_{1},T_{2},\dots,T_{r}\overset{\text{i.i.d.}}{\sim}\mathrm{Exp}(\lambda),那么通过上述的卷积公式可以算出 Z=T_{1}+T_{2}+\dots+T_{r} 的 PDF 为
f_{Z}(z)= \begin{cases}
\frac{\lambda ^{r}}{(r-1)!}z^{r-1}e^{-\lambda z} & z>0 \\
0 & \text{otherwise}
\end{cases}
这个分布就叫伽马分布(Gamma distribution),记作 \mathrm{Gamma}(r,\lambda).
再比如,若 X_{1},X_{2}, \dots, X_{n} 满足 X_{i}\sim N(\mu _{i}, \sigma _{i}^{2}),那么
\sum _{i=1}^{n}a_{i}X_{i}\sim N\left( \sum _{i=1} ^{n}a_{i}\mu _{i}, \sum _{i=1}^{n} a_{i}^{2} \sigma _{i}^{2}\right)
也就是说,独立的正态分布随机变量的线性组合也服从正态分布。
再比如,独立的泊松分布随机变量的和也是泊松分布,且 \lambda 为这些随机变量的 \lambda 之和。
随机变量求最值
若 Z=\max(X,Y),且 X,Y 相互独立,那么有:
F_{Z}(z)= F_{X}(z)F_{Y}(z)
若 Z=\min(X,Y),且 X,Y 相互独立,那么有:
F_{Z}(z)= 1-(1-F_{X}(z))(1-F_{Y}(z))
特别地,若 X_{1},X_{2}, \dots , X_{n} \overset{\text{i.i.d.}}{\sim}F(x),那么
F_{\max}(z)=(F(z))^{n},\quad F_{\min}(z)=1-(1-F(z))^{n}
中心极限定理(Central Limit Theorem, CLT)
若 X_{1},X_{2}, \dots 是一系列 i.i.d 随机变量,令 \mu \triangleq \mathrm{E}(X_{i}), \sigma ^{2}\triangleq \operatorname{Var}(X_{i})。令 S_{n}=X_{1}+X_{2}+\dots+X_{n},以及 \overline{X}_{n}=S_{n} / n,考虑 S_{n} 的标准化的版本:
Z_{n}= \frac{S_{n}-\mathrm{E}(S_{n})}{\sqrt{\operatorname{Var}(S_{n})}}= \frac{S_{n}-n\mu}{\sqrt{n\sigma ^{2}}}= \frac{\sqrt{n}(\overline{X}_{n}-\mu)}{\sigma}
那么 中心极限定理(CLT) 告诉我们,当 n\to \infty,有 Z_{n} 依分布收敛(Converges in distribution)到一个标准正态随机变量:
F_{Z_{n}}(z)=P(Z_{n}\leq z) \overset{n\to \infty}{\to} \Phi (z) \forall z
这里若 X_{1},X_{2}, \dots 就是服从正态分布的,那么不用 n\to \infty 就会得到一个标准正态随机变量。
经验法则:当 n\geq30 时可以考虑用标准正态分布来近似。
从中心极限定理就可以推出,n\to \infty 时,二项分布近似于正态分布。具体来说,若 S_{n}=X_{1}+\dots+X_{n},其中 X_{1},X_{2},\dots,X_{n}\overset{\text{i.i.d.}}{\sim}\mathrm{Bernoulli}(p):
\frac{S_{n}-np}{\sqrt{np(1-p)}} \overset{\text{approx.}}{\sim}N(0,1)
那么
S_{n} \overset{\text{approx.}}{\sim} N(np,np(1-p))
之前我们还了解到,二项分布也可以用泊松分布估计。这里的经验:
- 若
n大且p很小的时候,比如n>100,p<0.05,考虑用泊松分布\mathrm{Poisson}(np)近似。 - 若
np\geq 5,n(1-p)\geq5,考虑用正态分布N(np,np(1-p))近似。
连续性修正。
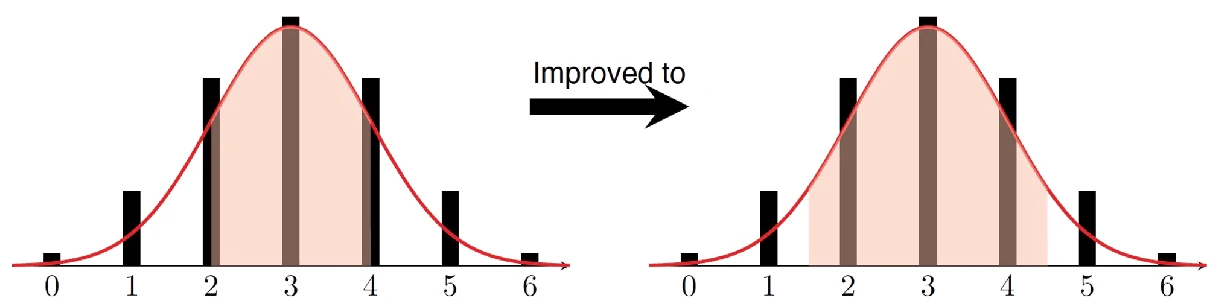
对整数值随机变量应用中心极限定理的时候(例如估计二项分布),若要算一个区间上的概率,先写成整数端点的闭区间,再把区间左右各扩大 0.5 会算得更准确。极端情况: P(X=x) 转而计算 P(x-0.5\leq X\leq x+0.5)。
多元正态分布
二元随机变量 (X,Y) 是二元正态分布,当它的 PDF 为
f(x,y)=\frac{1}{2\pi \sigma _{X}\sigma _{Y}\sqrt{1-\rho ^{2}}} \exp\left( - \frac{1}{2(1-\rho ^{2})} \left[ \frac{(x-\mu _{X})^{2}}{\sigma _{X}^{2}} -2\rho \frac{(x-\mu _{X})(y-\mu _{Y})}{\sigma _{X}\sigma _{Y}}+ \frac{(y-\mu _{Y})^{2}}{\sigma _{Y}^{2}}\right]\right)
这里 \mu _{X},\mu _{Y} 就是 X,Y 的均值,\sigma _{X},\sigma _{Y} 为标准差,\rho 是 X,Y 之间的相关系数。
这可以写成:
\begin{bmatrix}
X \\
Y
\end{bmatrix}\sim N(\begin{bmatrix}
\mu _{X} \\
\mu _{Y}
\end{bmatrix}, \begin{bmatrix}
\sigma _{X}^{2} & \rho \sigma _{X}\sigma _{Y} \\
 \rho \sigma _{X}\sigma _{Y} & \sigma _{Y}^{2}
\end{bmatrix})= N(\boldsymbol{\mu}, \boldsymbol{\Sigma})
这里 \boldsymbol{\mu} 称为均值向量(Mean Vector),而 \boldsymbol{\Sigma} 称为方差-协方差矩阵(Variance-Covariance Matrix)。
特别地,若 \mu _{X}=\mu _{Y}=0,\sigma _{X}=\sigma _{Y}=1,\rho=0,那么称为标准二元正态分布:
N(\boldsymbol{0},\boldsymbol{I})
性质 1: 若 \begin{bmatrix}X_{1} \\ X_{2}\end{bmatrix}\sim N(\boldsymbol{\mu},\boldsymbol{\Sigma}),那么 X\sim N(\mu _{X},\sigma _{X}^{2}),Y\sim N(\mu _{Y},\sigma _{Y}^{2}),且 \rho _{XY}=\rho。
性质 2: 对于二元正态分布,若 X,Y 不相关,那么 X,Y 相互独立。(多元正态分布中,变量之间只存在线性关系)
- 注意,这个“相关推独立”需要
(X,Y)服从二元正态分布。如果X,Y只是各自服从正态,不会有这个结论。 - 一个反例:令
X\sim N(0,1),Z与X独立,满足P(Z=1)=P(Z=-1)=0.5,那么随机变量Y=ZX也服从N(0,1),且X,Y不相关。 - 但是,
X,Y并不相互独立。 - 这里还有一个结论:若
X,Y各自服从正态,且它们相互独立,那么(X,Y)满足二元正态分布。
性质3: 若 \begin{bmatrix}X \\ Y \end{bmatrix}\sim N(\boldsymbol{\mu},\boldsymbol{\Sigma}) ,那么有
X\mid Y=y\sim N\left( \mu _{X}+ \frac{\rho \sigma _{X}}{\sigma _{Y}}(y-\mu _{Y}) , (1-\rho ^{2})\sigma _{X} ^{2}\right)
Y\mid X = x\sim N\left( \mu _{Y}+ \frac{ \rho \sigma _{Y}}{\sigma _{X}}(x-\mu _{X}), (1-\rho ^{2})\sigma _{Y}^{2} \right)
也就是说,条件分布也是正态分布,且也能看出线性关系:
\mathrm{E}(Y\mid X=x)=a+bx
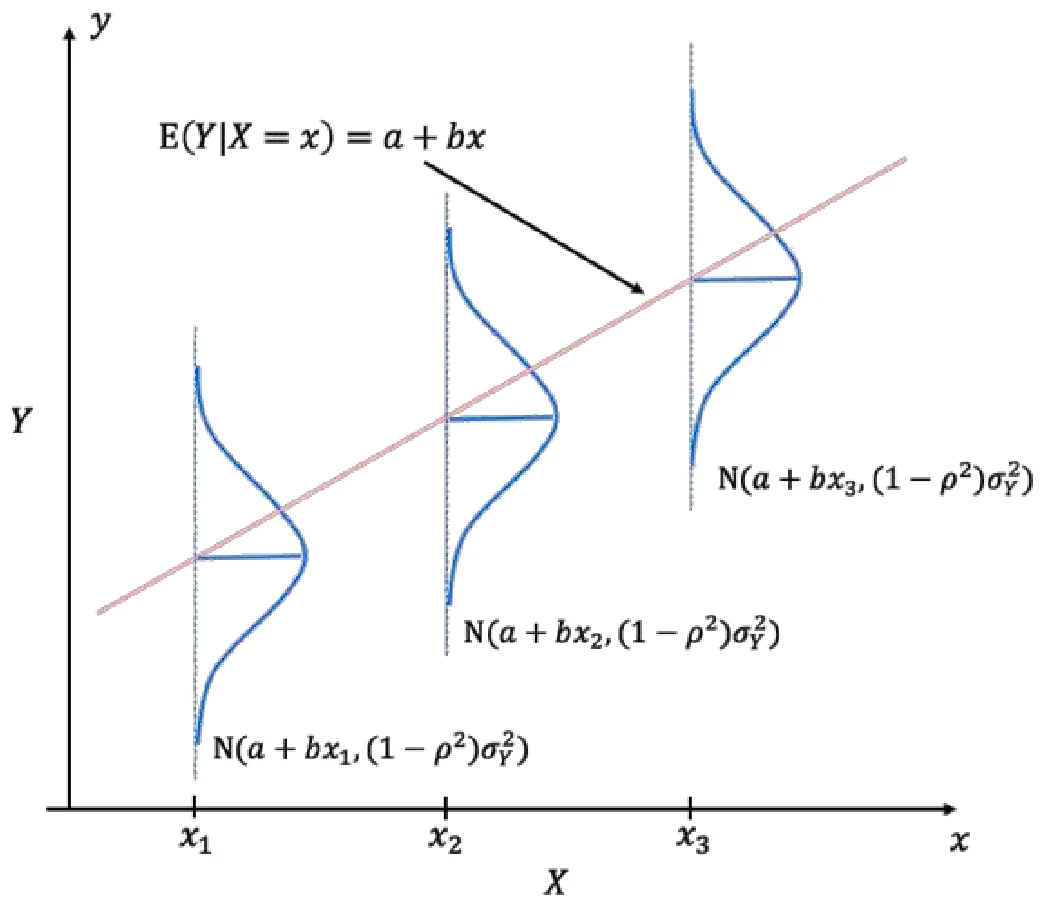
性质 4: 若 \begin{bmatrix}X \\ Y \end{bmatrix}\sim N(\boldsymbol{\mu},\boldsymbol{\Sigma}) ,那么对于任意常数 c_{1},c_{2} 有
c_{1}X+c_{2}Y\sim N(c_{1}\mu _{X}+c_{2}\mu _{Y},c_{1}^{2}\sigma _{X}^{2}+2c_{1}c_{2}\rho \sigma _{X}\sigma _{Y}+c_{2}^{2}\sigma _{Y}^{2})
更一般的情况:对于任何 2\times2 实矩阵 A,有:
\boldsymbol{A}\begin{bmatrix}
X \\
Y
\end{bmatrix} \sim N(\boldsymbol{A}\boldsymbol{\mu},\boldsymbol{A}\boldsymbol{\Sigma}\boldsymbol{A}^{\top})
扩展成多元的情况:
\boldsymbol{X}=\begin{bmatrix}
X_{1} \\
X_{2} \\
\vdots \\
X_{n}
\end{bmatrix},\quad \boldsymbol{\mu}=\mathrm{E}(\boldsymbol{X})=\begin{bmatrix}
\mathrm{E}(X_{1}) \\
\mathrm{E}(X_{2}) \\
\vdots \\
\mathrm{E}(X_{n})
\end{bmatrix}
以及方差-协方差矩阵:
\boldsymbol{\Sigma}=\operatorname{Cov}(\boldsymbol{X})=\mathrm{E}[(\boldsymbol{X}-\mathrm{E}(\boldsymbol{X}))(\boldsymbol{X}-\mathrm{E}(\boldsymbol{X}))^{\top}]=\begin{bmatrix}
\operatorname{Var}(X_{1}) & \operatorname{Cov}(X_{1}, X_{2}) & \cdots & \operatorname{Cov}(X_{1}, X_{n}) \\
\operatorname{Cov}(X_{1}, X_{2}) & \operatorname{Var}(X_{2})  &  & \vdots \\
\vdots &  & \ddots & \vdots \\
\operatorname{Cov}(X_{1}, X_{n}) & \cdots & \cdots & \operatorname{Var}(X_{n})
\end{bmatrix}