Introduction
本页目录
算法(Algorithms)
定义:一个良定义的计算步骤,接受输入(input)并产生输出(output)
- 用于解决计算问题(Computational problem)
例如:排序问题 (Sorting Problems) - 输入: 一个包含
n个数字的序列 - 输出:一个输入序列的排列,使得这些数呈升序。
一个具体的输入叫做实例(instance)。
算法应能解决所有可能的实例。
我们用伪代码(Pseudocode)来描述算法。
正确性(Correctness)
- 能解决所有可能的实例。
- 可以证明。
衡量算法的时间:Random-access machine (RAM) model
定义初等操作:
- 算数:加减乘除取余
- 逻辑运算,移位,比较
- 数据的移动:变量赋值
- 控制:循环,子进程/方法的调用
假设所有的操作都消耗相同的时间。
算法的运行时间(Runtime)取决于初等操作的次数。
插入排序
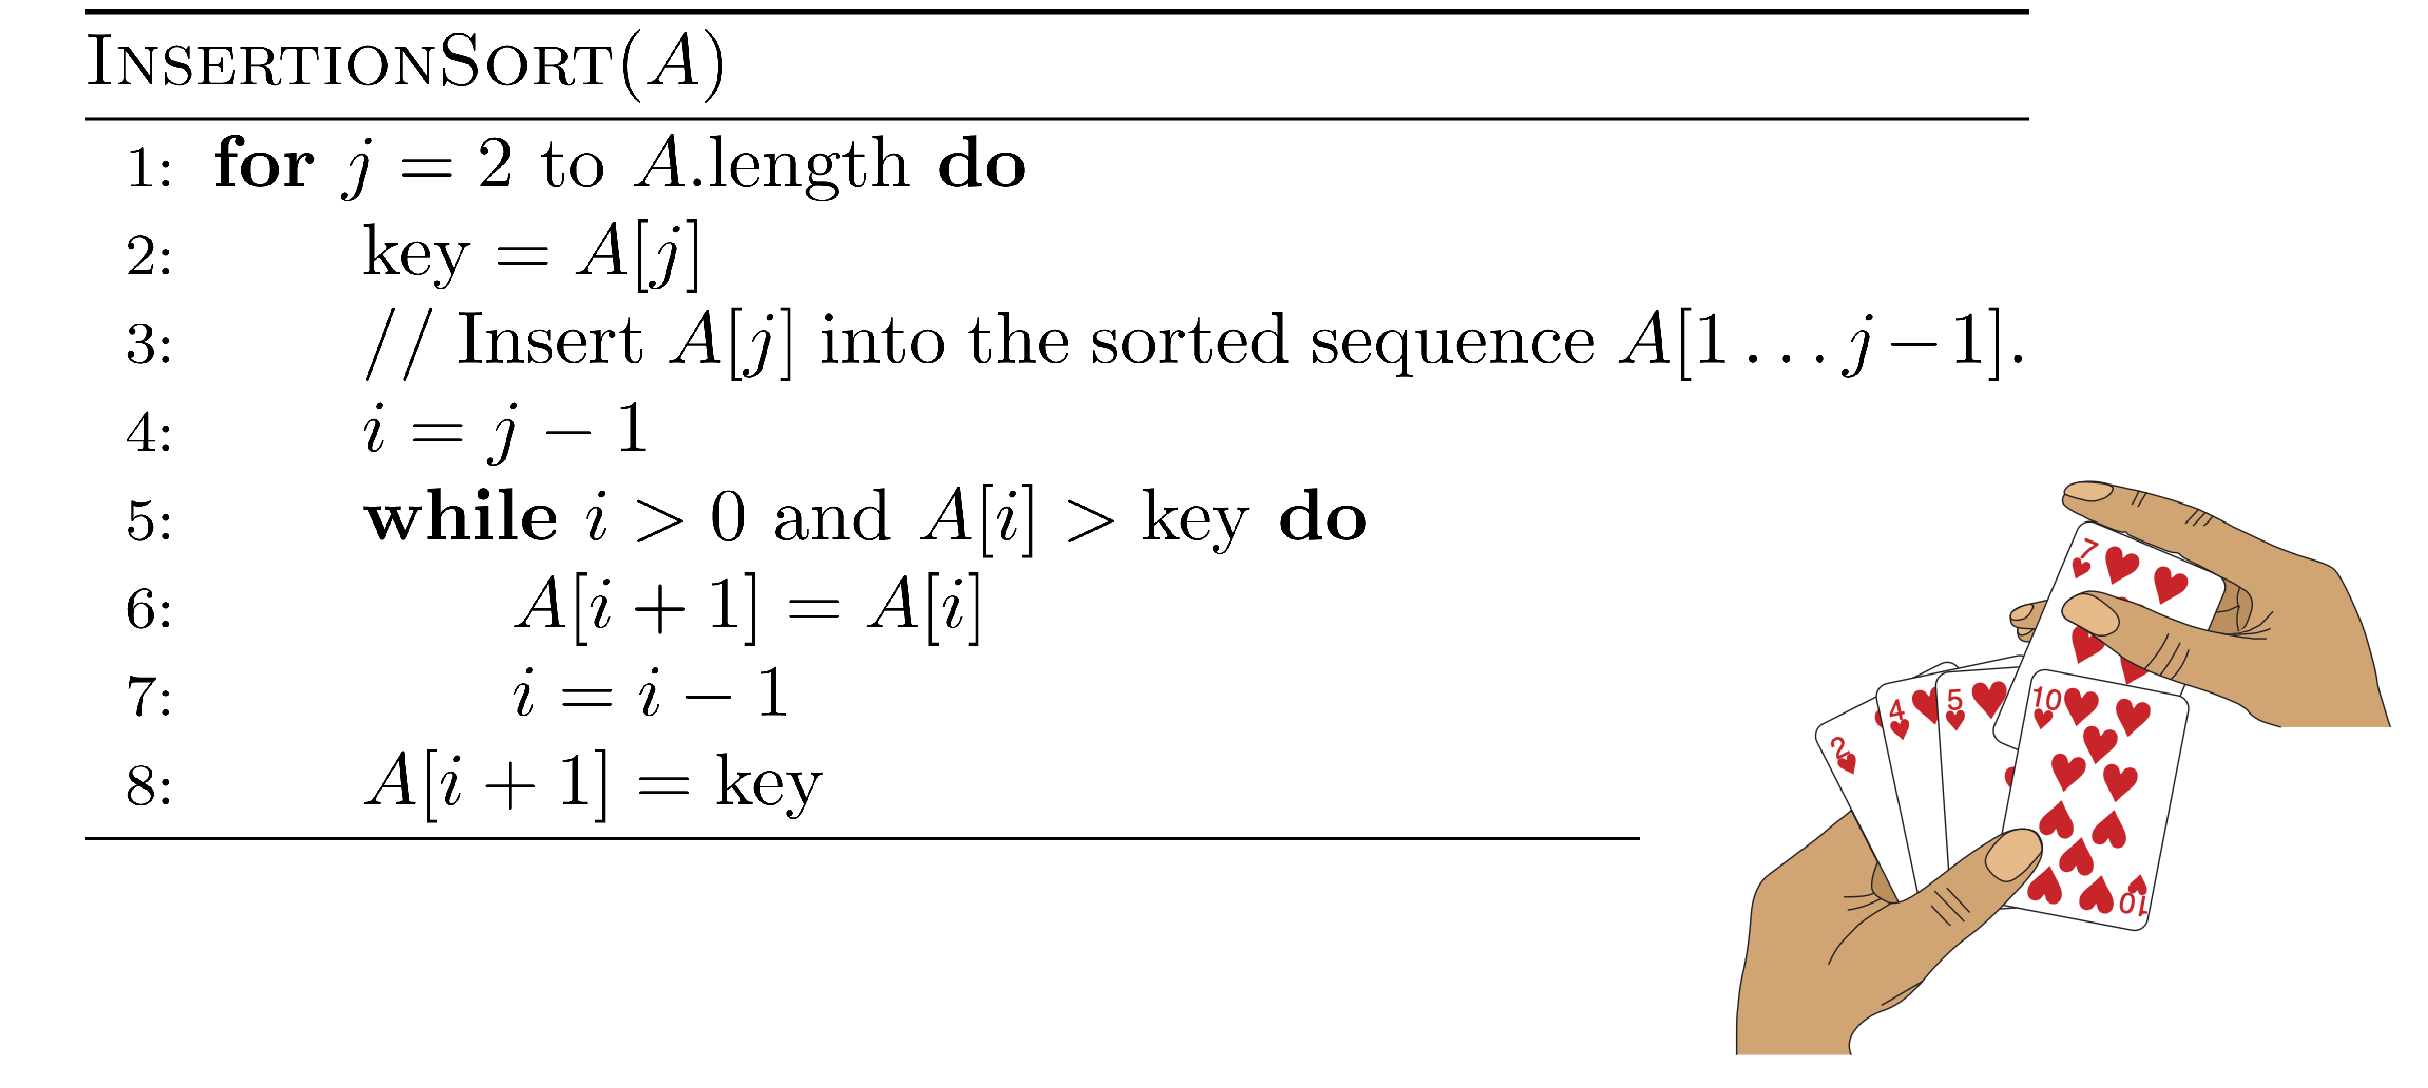
证明正确性
Proof by loop invariant (通过循环不变量证明)
- 循环不变量:在循环的过程中,一个永远正确的陈述,可以反映算法的进度。
- 类似与数学归纳法,我们先说明这个循环不变量在初始时是正确的(Initialisation),再说明
i次迭代中正确可推第i+1次迭代中正确(Maintenance),最后说明算法结束时这个循环不变量可以推出算法正确(Termination) - 例如,对于插入排序,循环不变量可以是:
在每次迭代开始时,子数组
A[1\dots j-1]包含了原数组A[1\dots j-1]的所有元素,且是排好序的。 - 通过说明 Initialisation, Maintenance, Termination 即可证明。
运行时间
通过粗暴的对每一行计算运行的次数再求和,我们可以得到一个这样的式子:
T(n)=c_{1}n+c_{2}(n-1)+c_{4}(n-1)+c_{5}\sum_{j=2}^nt_{j}+(c_{6}+c_{7})\sum_{j=2}^n (t_{j}-1) +c_{8}(n-1)
最好的情况(Best case)下(数组已排序),t_{j}=1:
T(n)=an+b
最坏的情况下(Worst case)(完全逆序),t_{j}=j:
T(n)=an^{2}+bn+c
平均情况(Average case):例如对于排序,假设所有排列方式是等可能的,那么可以算出一个平均时间。但是对于很多问题,很难找到一个“Average”的定义方式。
因此,最坏的情况往往很重要,它保证了算法不会花的更久。很多情况下,平均时间就和最坏情况一样坏。
渐进记号(Asymptotic Notation)
运行时间关于 n 的增长速度只取决于最高阶的项。因此我们可以用渐进记号来表示运行时间的增长速度。例如:
2n^{2}+3n=\Theta (n^{2})
形式化的,我们可以记 f(n)=\Theta(g(n)),若存在常数 n_{0},0<c_{1}\leq c_{2},使得当 n\geq n_{0} 时,有 0\leq c_{1}g(n)\leq f(n)\leq c_{2}g(n)。
数学上,\Theta(g(n)) 其实是满足上述定义的所有 f(n) 的集合,因此严谨的记号是 f(n)\in \Theta(g(n))。然而,按惯例,我们记作 f(n)=\Theta(g(n))。我们说,g(n) 是 f(n) 的渐近紧确界(asymptotically tight bound)。
这里 \Theta(g(n)) 同时表示了 f(n) 的上界和下界。另外有 O(g(n)),只表示上界(Upper bound);以及 \Omega(g(n)),只表示下界(Lower bound)。形式化的定义方式与 \Theta 类似。
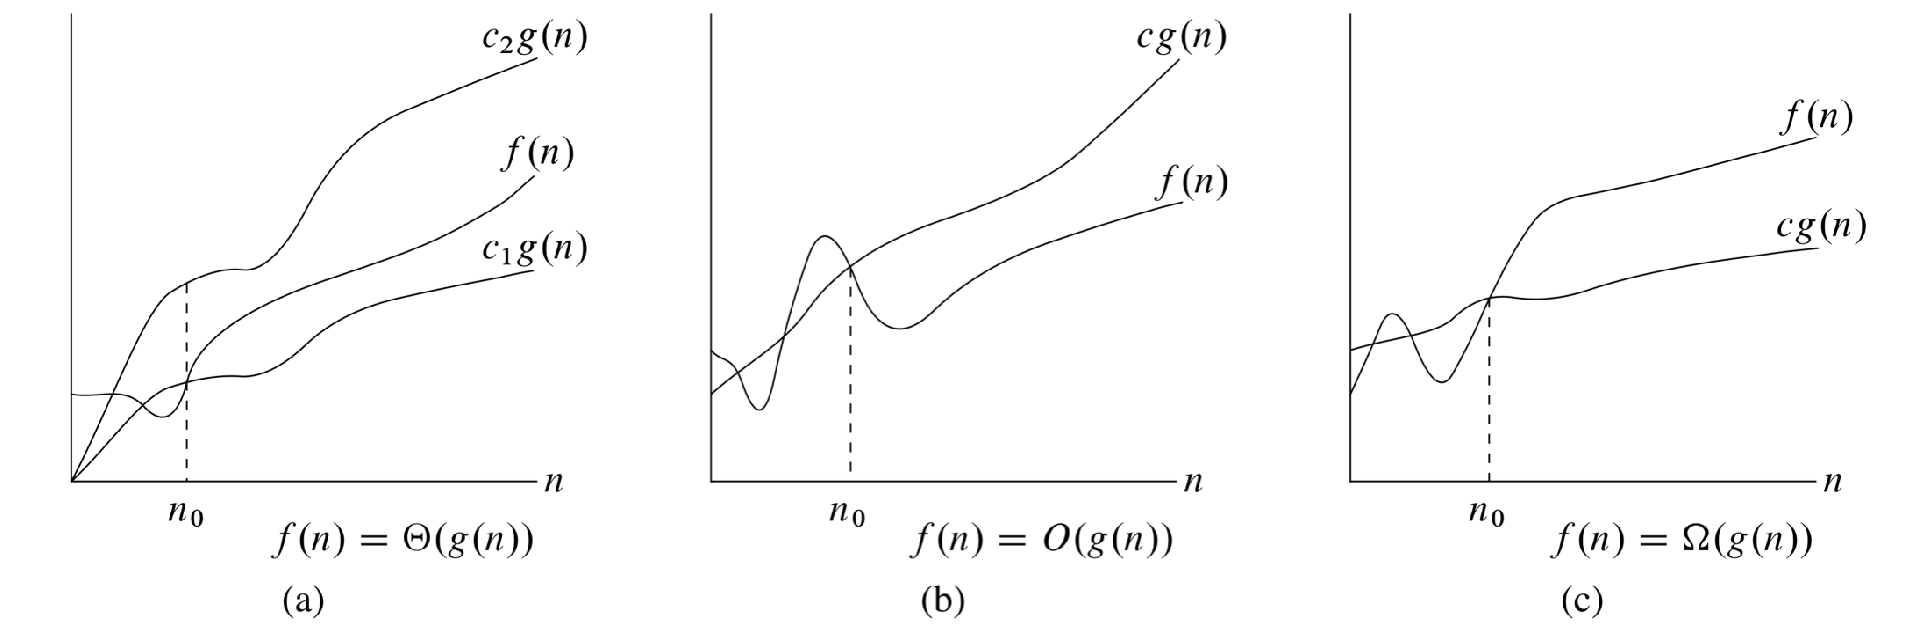
O 与 \Omega 都弱于 \Theta。同时满足这两个可以得出 \Theta。
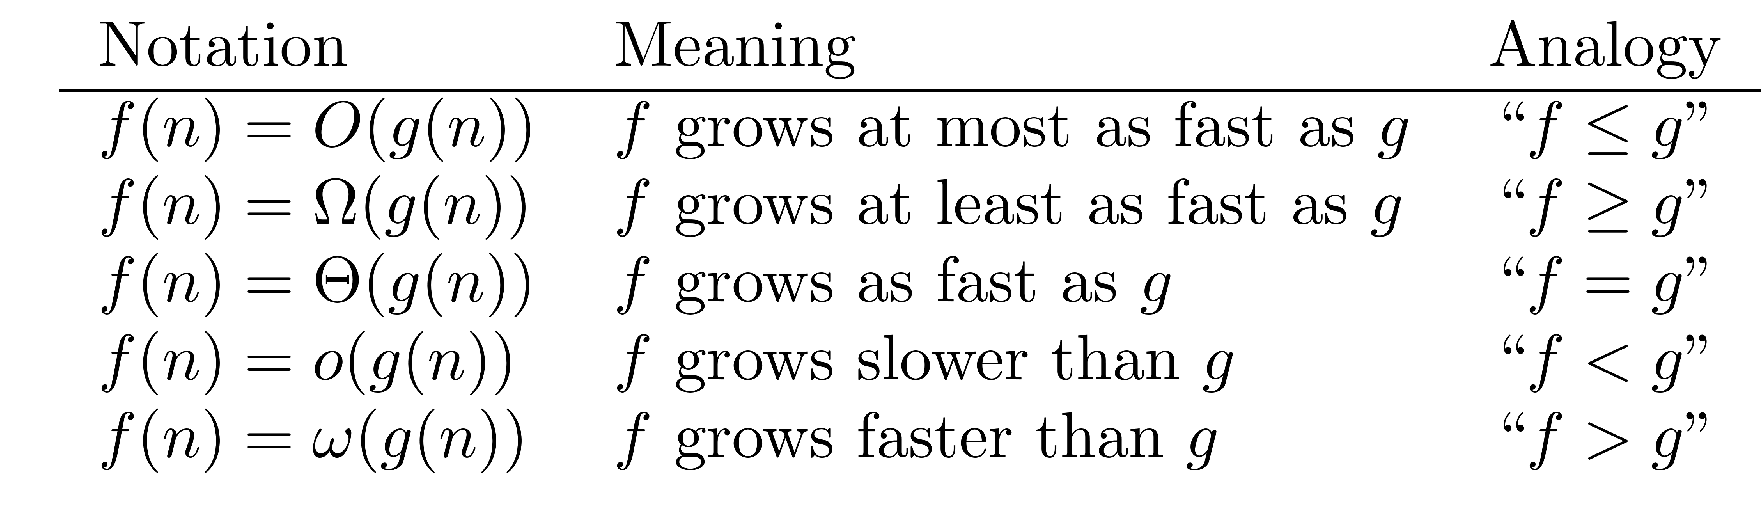
另外还有 o(g(n)) 表示严格小于某个上界(对任意常数 c,f(n)<cg(n),也就是说 \lim_{ n \to \infty }f(n)/g(n)=0),\omega(g(n)) 表示严格大于某个上界。若 f(n)=o(g(n)),我们说 f(n) 渐进小于(Asymptotically Smaller) g(n)。类似的有渐进大于(Asymptotically larger)
常用的:
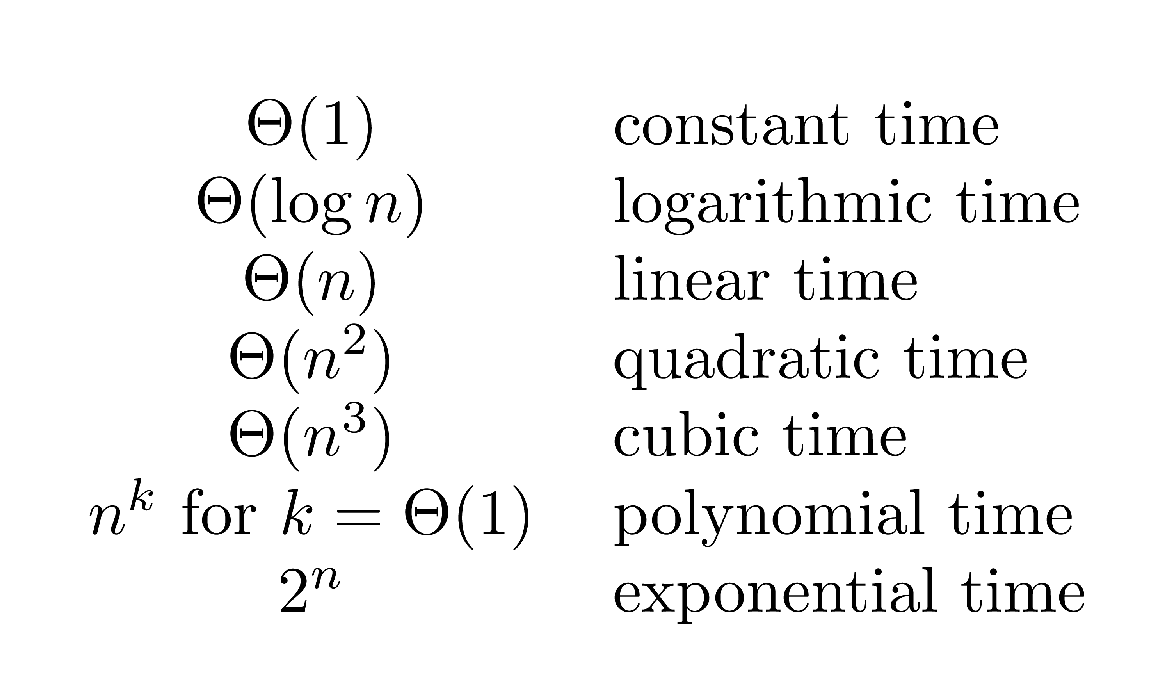
其中,任何 \log n 的多项式都比 n 的多项式增长得慢;任何 n 的多项式都比 2^{n^{\varepsilon}} 增长得慢。
渐进记号表示的是运行时间的增长速度和 g(n) 之间的关系(一样快/至少/至多/大于/小于…)
要找到 c_{1},c_{2},n_{0} 以证明渐进记号的正确性,通常在两边同时除以 g(n) 以化简不等式。
一定要注意 c_{1}>0,也要注意不等式应该对所有 n\geq n_{0} 成立。
对于非负函数 f(n) 和 g(n):
f(n)+g(n)=\Theta(\max(f(n), g(n)))\Theta(f(n))\cdot\Theta(g(n))=\Theta(f(n)\cdot g(n))
我们可以写 O(n)=O(n^{2}),这里指的是子集的关系,O(n)\subset O(n^{2})。但是不能写 O(n^{2})\subset O(n)。
这样的式子: 2n^{2}+\Theta(n)=\Theta(n^{2}) 指的是,对于任意的左边的匿名函数(Anonymous Function) f(n)\in \Theta(n), 总存在一个右边的匿名函数 g(n)\in \Theta(n^{2}),使得等式成立。
并不是任意两个函数都是渐进可比的。
分治算法
A design paradigms: Divide-and-conquer.
- Divide
- Conquer
- Combine
归并排序(MergeSort)
- 把数组对半分。
- 递归地排序两个更小的数组。
- 合并两个子数组。
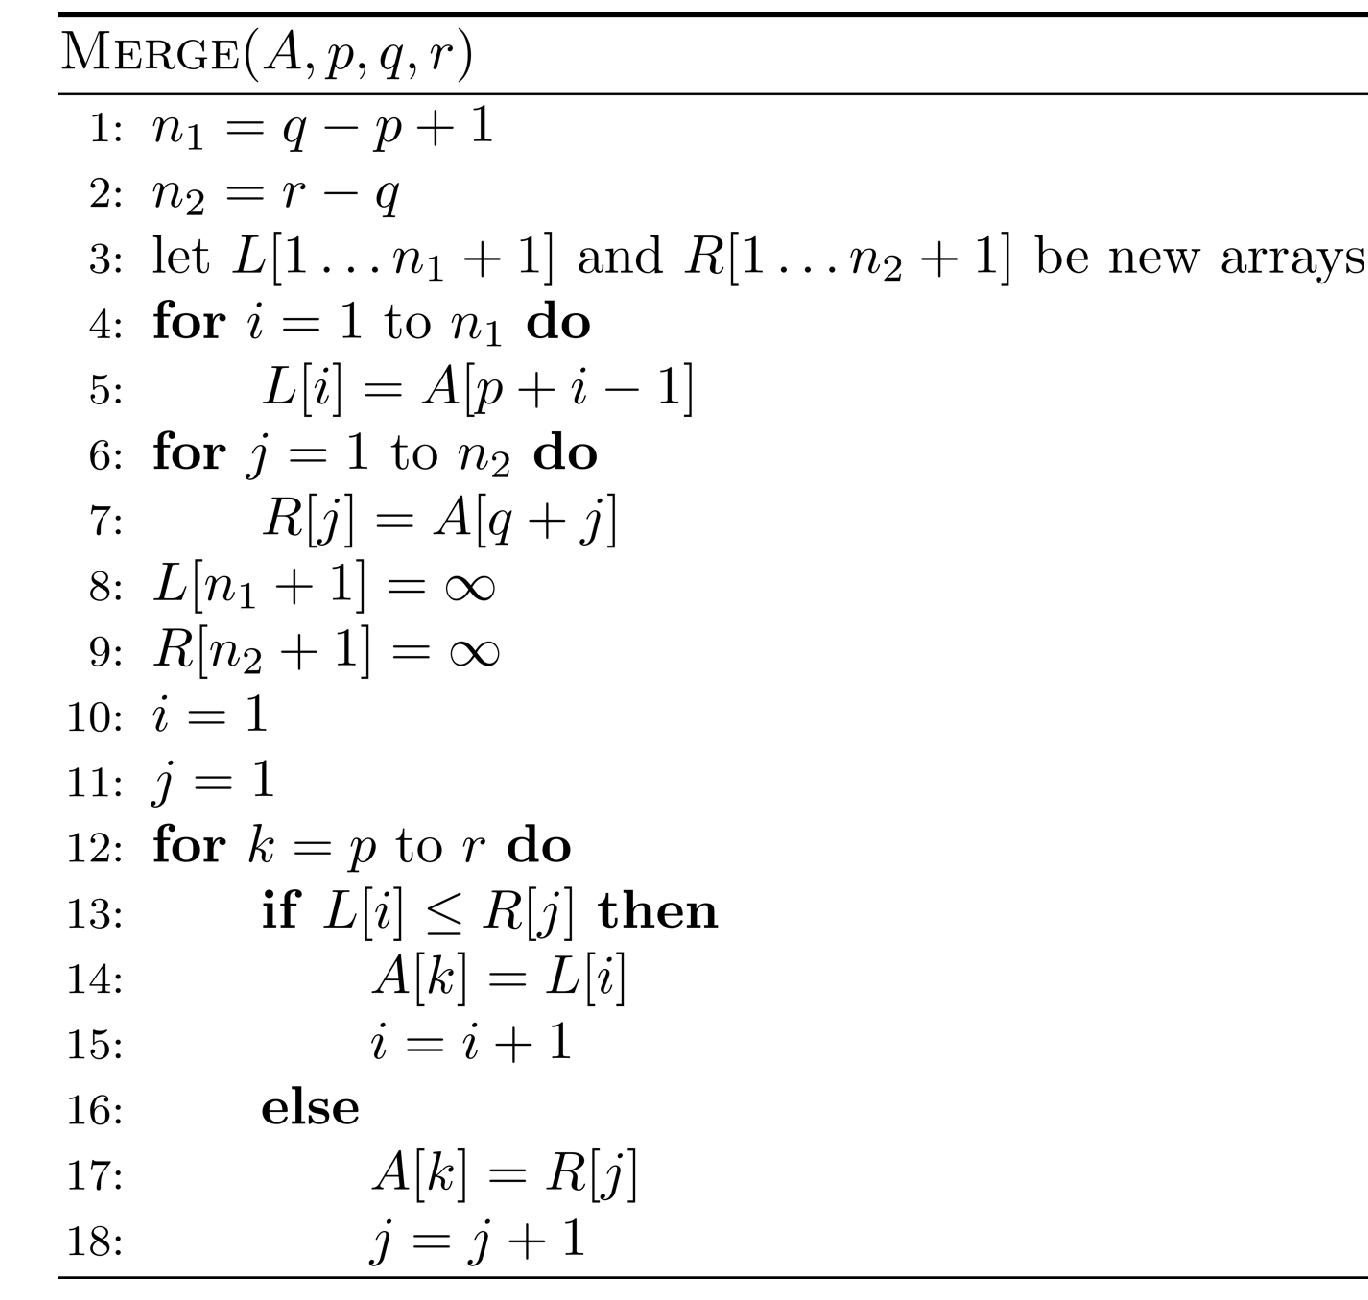
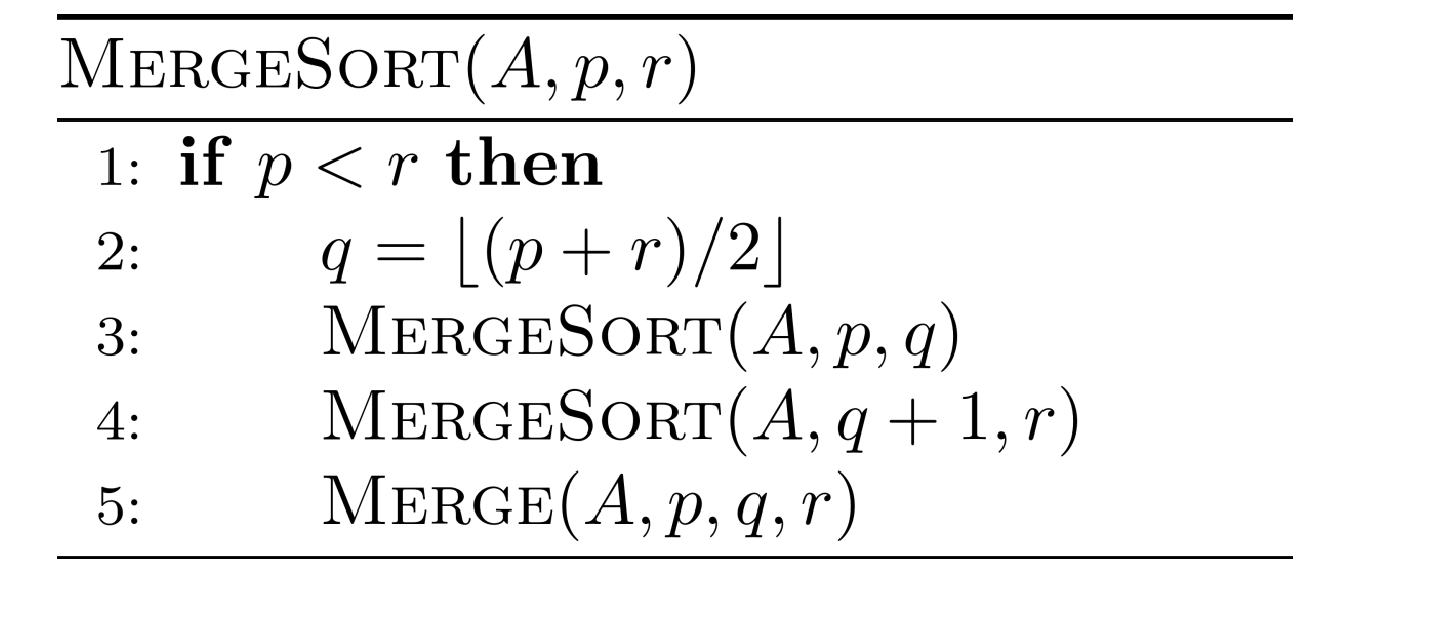
归并排序的正确性证明
- 对于函数 Merge(),我们可以用 Loop Invariant 证明。这里的 Invariant 可以选为:“在每次迭代开始时,
A[p\dots k-1]包含了L[p\dots q]和R[q+1\dots r]中最小的k-p个元素且是排好序的;而且L[i]和R[j]分别是在L和R还没复制到A中的元素中最小的。” - 对于函数 MergeSort (),可以用归纳证明(Strong Induction)。对
n=1显然能正确排序。假设对大小为1\leq n\leq k的数组成立,那么对n=k+1,由于两个子问题都在成立的范围内,容易证明也能成功排序,因而证明对于任意n都能正确排序。
运行时间的递归式(Recurrence Equation):
T(n)=\begin{cases}
2T(n/2)+\Theta(n) & n>1\\
\Theta(1) & n=1
\end{cases}
归并排序需要 \Omega (n) 的额外空间,而插入排序只需要 O(1)。
所以我们说插入排序是原地的(In place)。
解递归式
有三种方式:
- Substitution Method:先猜测一个解,再结合定义,用归纳法证明。
- Recursion Tree:用于猜测解,以及若画的严格的时候也可以直接证明解。
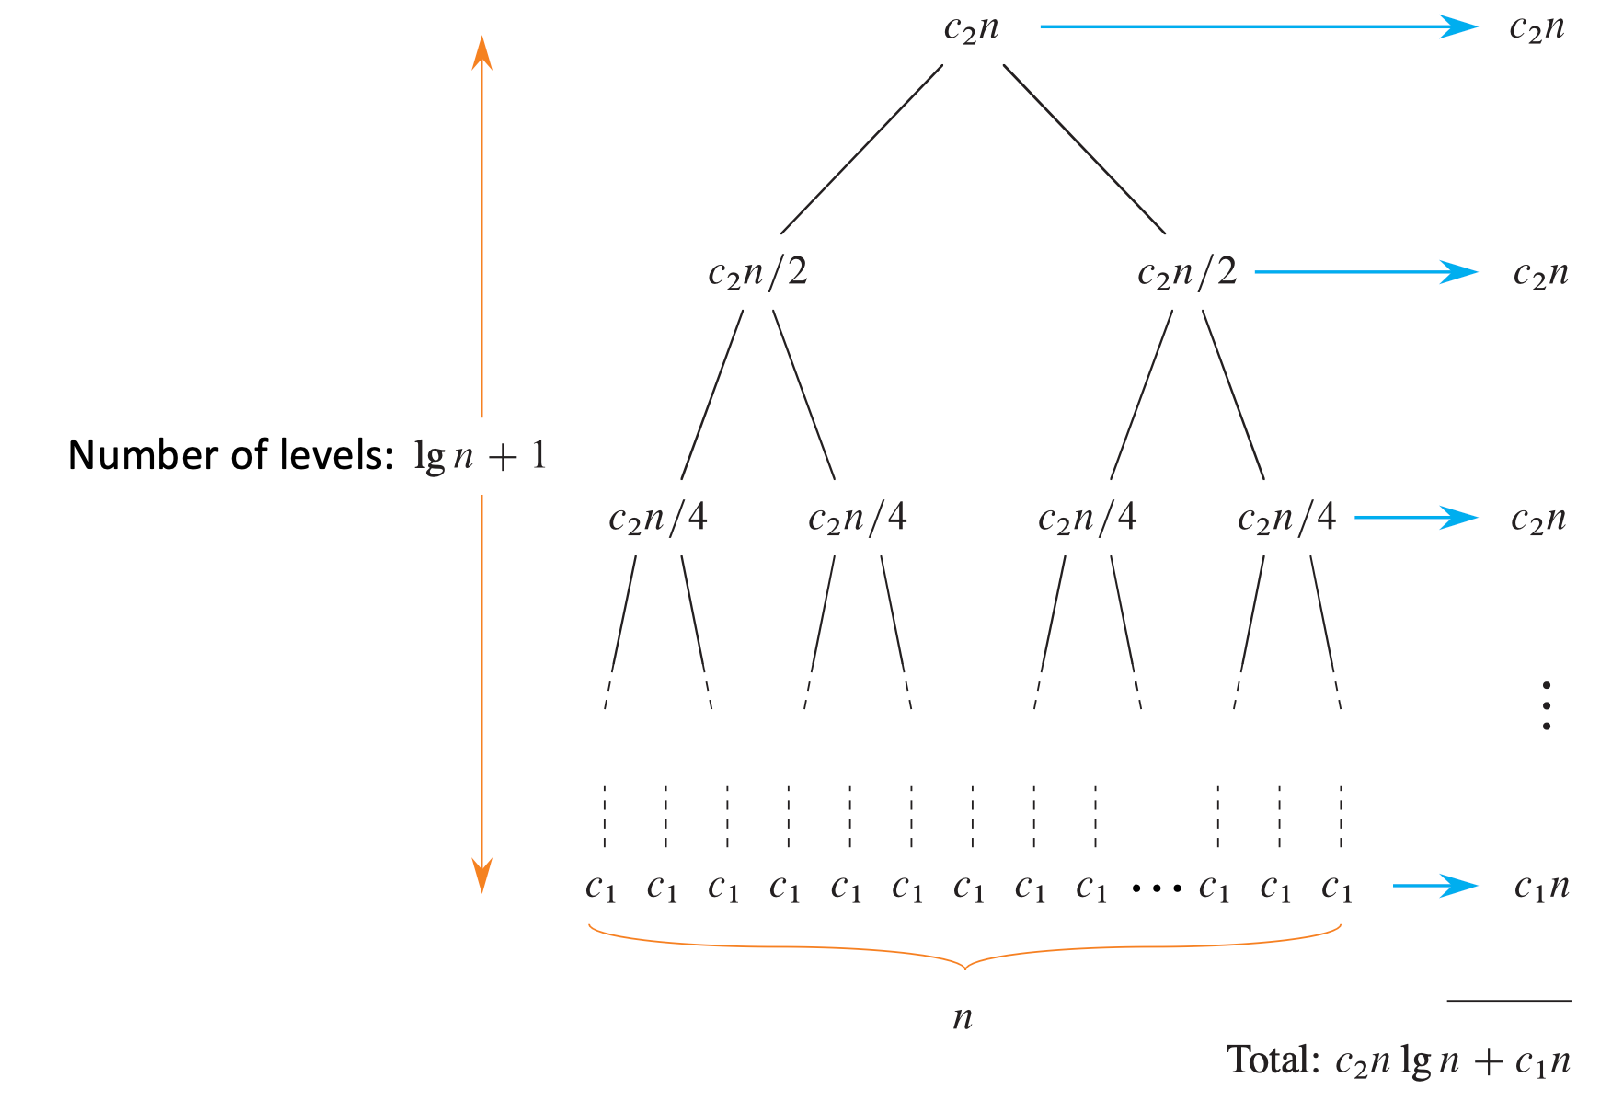
- Master Theorem:对于形式
T(n)=aT(n / b) + f(n)
其中a\geq 1, b>1。
我们称f(n)为 driving function(表示 divide 和 combine 的代价),而T(n)称为 master recurrence(表示我们分成a个子问题,每个需要T(n / b)的时间解决)。另外称n^{\log_{b}a}为 watershed function。
那么 The Master Theorem 指出:
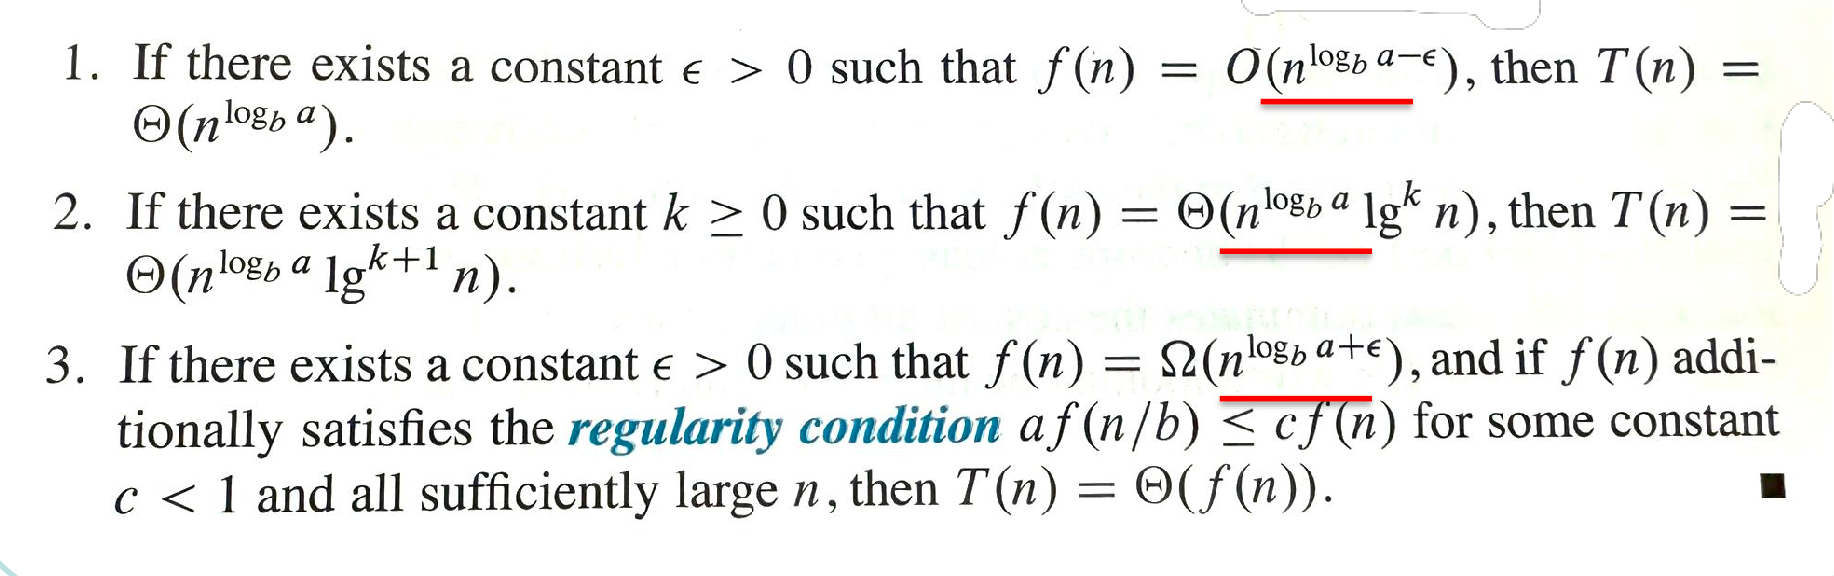
三种情况分别为: f(n)相比于 watershed 来说小一个多项式的量级(慢\Theta(n^{\varepsilon}))。f(n)和 watershed 差不多量级(差的只是\log^kn的量级)。f(n)相比于 watershed 来说大一个多项式的量级(快\Theta(n^{\varepsilon}))且要满足 regularity condition (存在c<1使得af(n / b) \leq cf(n))
应用到归并排序上:a=2,b=2\implies\text{watershed=}n^{1}; f(n)=\Theta(n),那么是处于 Case 2,且 k=0, 于是得到 T(n)=\Theta(n\log n)。