Data Structures
本页目录
数据结构(Data Structures)是用来维护 动态集合(Dynamic sets) 的技术。集合中的每个元素包含:
- Key。用来唯一确定这个元素。
- Satellite data。不被数据结构维护的数据。
- Attributes。被数据结构维护的数据。
这里 Key 通常来自一个全序集(Totally Ordered Set),例如正整数集。 - 这样,就会有最小/最大的 key,每个 key 也会有前驱/后继。
常见的操作: - Search(S, k):返回 key 为 k 的元素的 pointer。
- Insert(S, x):把 pointer
x指向的元素加到S里 。 - Delete(S, x):把 pointer
x指向的S中的元素从S中删掉。 - Minimum(S), Maximum(S) :返回 key 最小/最大的元素的 pointer。
- Successor(S, x), Predecessor(S, x) :返回比 pointer
x指向的元素的 key 的下一个更大/更小的元素的 pointer。
基本数据结构
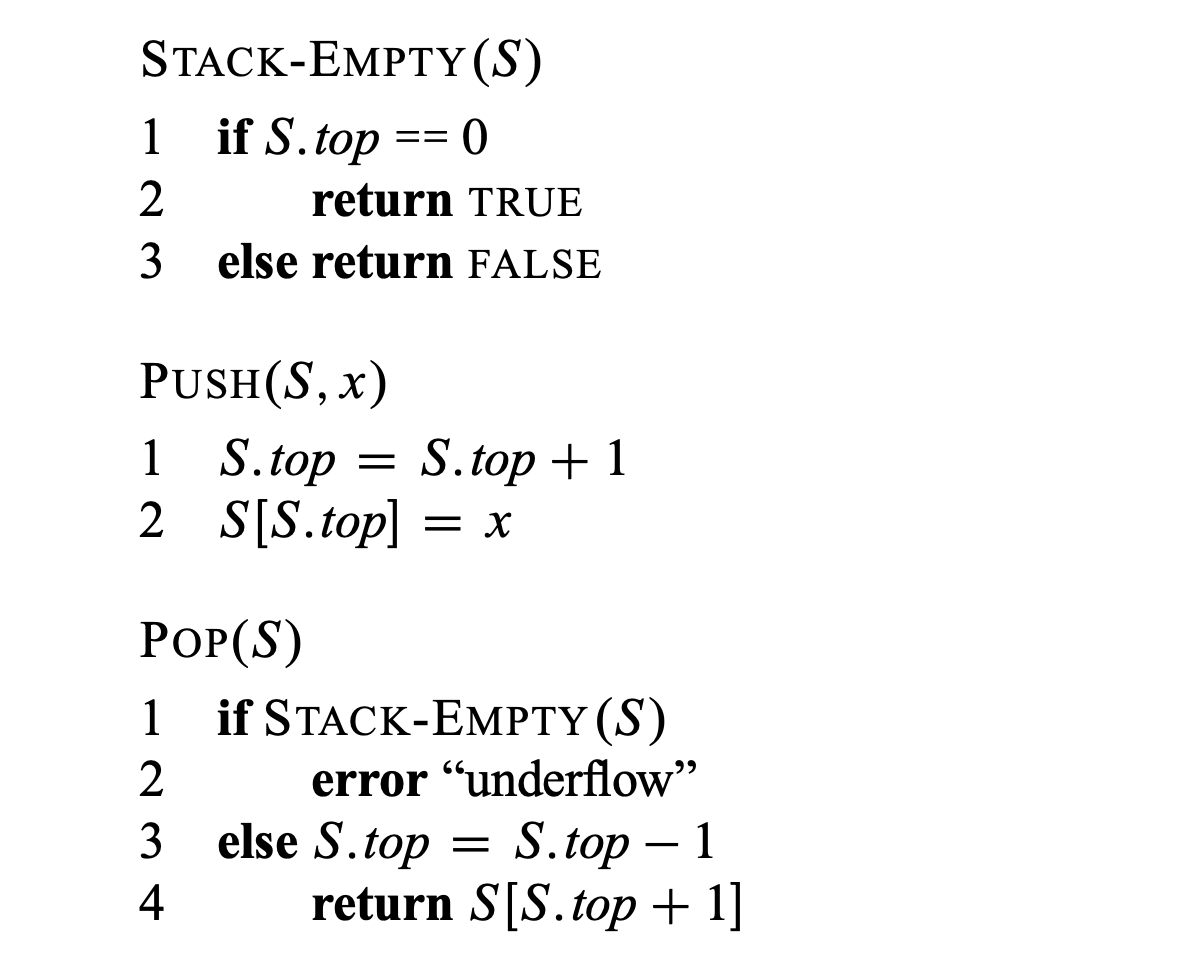
栈(Stack)
后进先出(last-in, first-out / LIFO)。可以用数组实现:
队列(Queue)
先进先出(first-in, first-out / FIFO)。也可以用数组实现:
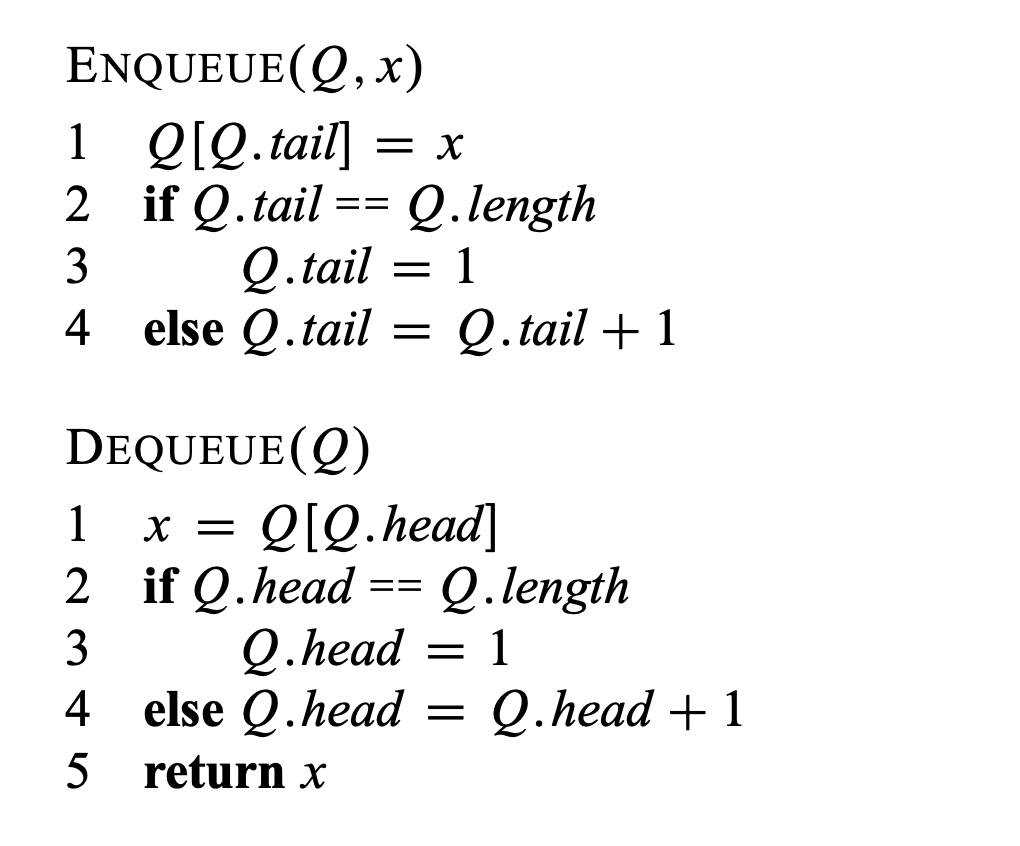
这些操作都是 O(1) 的。
优先队列(Priority Queues)
用一个堆来实现。这里就是把出队操作变成弹出具有最大/最小的 key 的元素。另外,以最大堆实现的 max-priority queue为例,还可以支持增大一个元素的 key,只需要 float up 即可。
- handle: 把一个对象与它在一个数据结构(比如堆)中的位置映射起来。在操作中我们也要去维护每个对象的 handle。
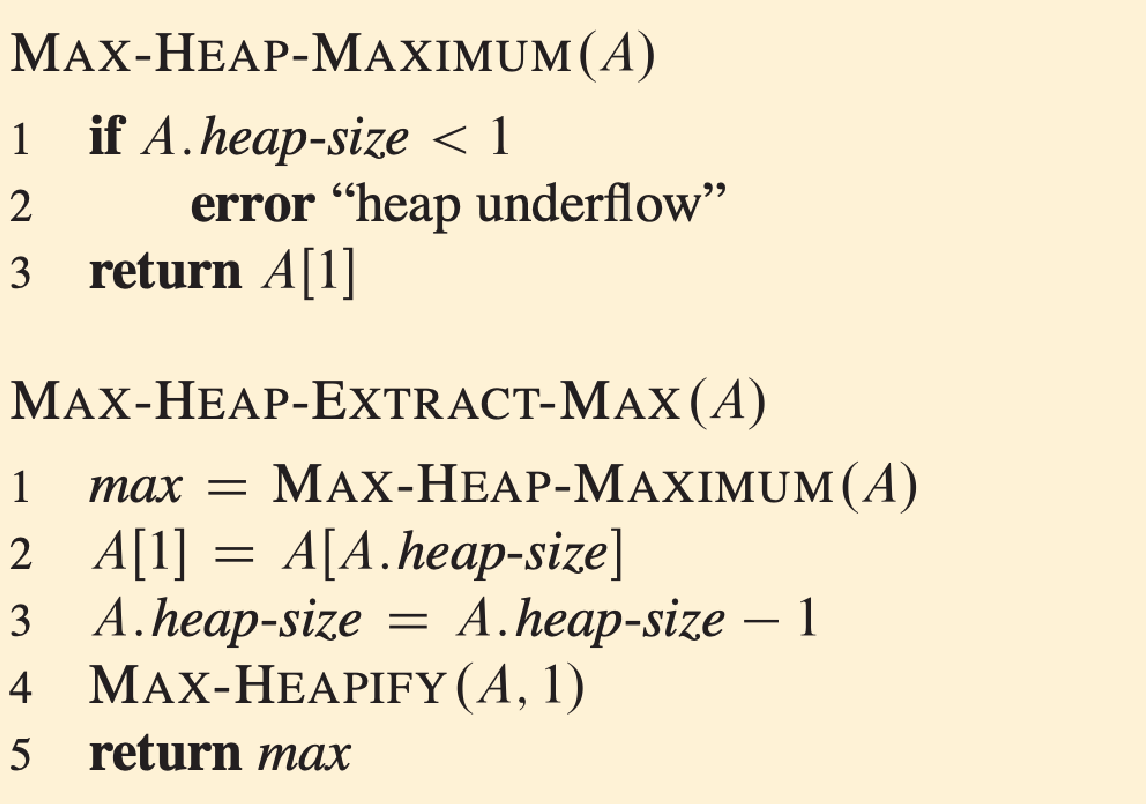
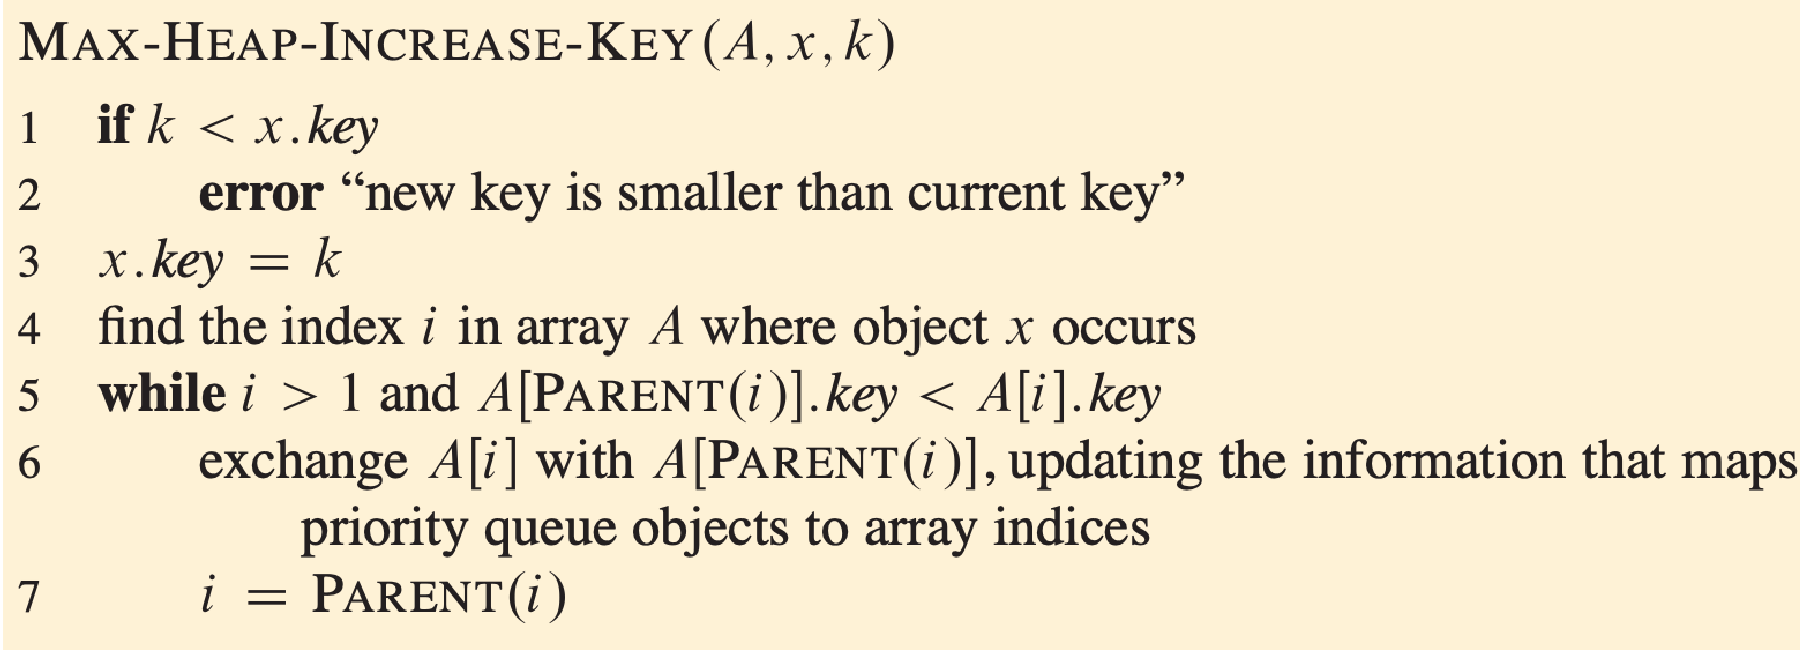
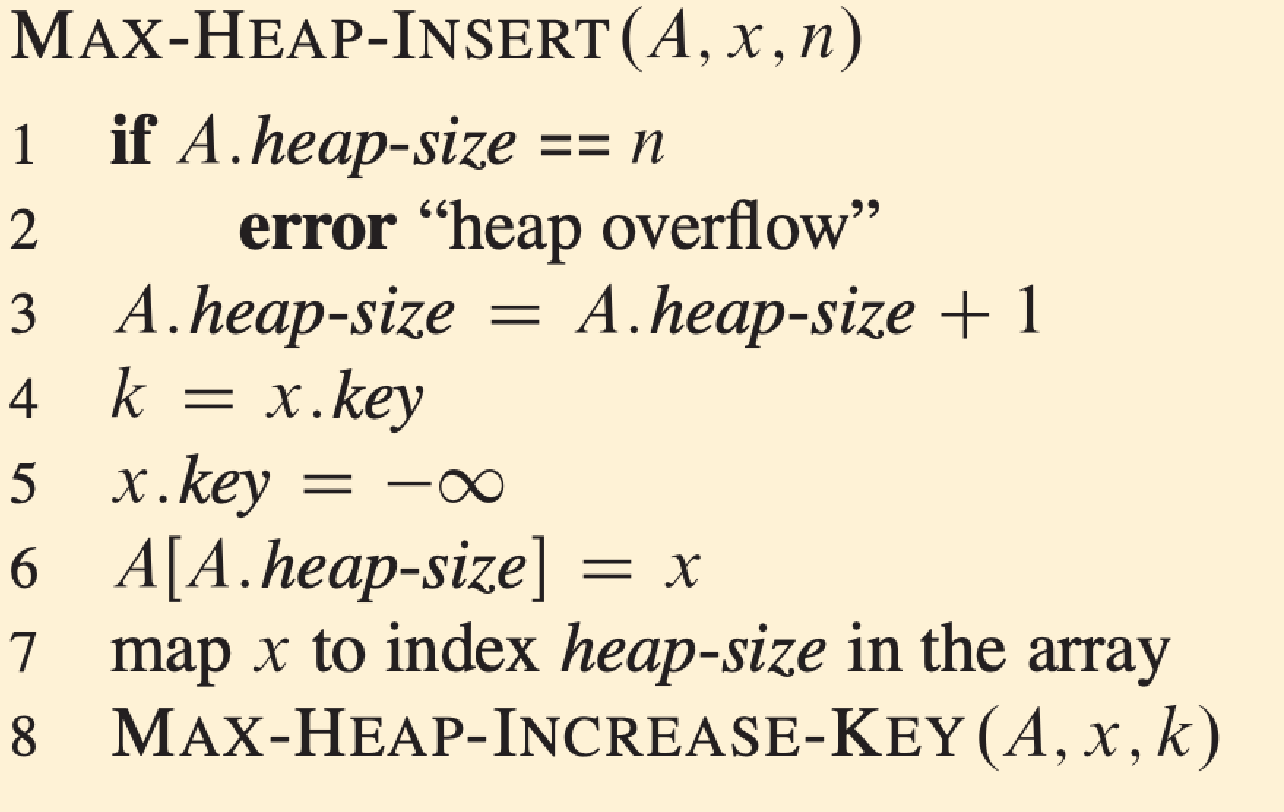
这些操作最多都是 O(\log n) 的。
链表(Linked List):
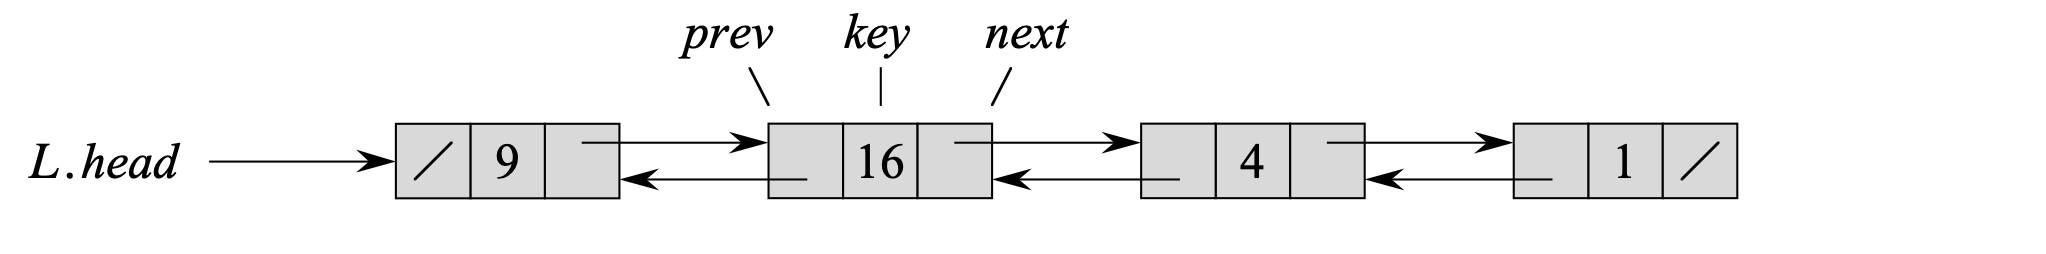
除了 key,还对每一个元素 x 存两个 attribute:x.prev 和 x.next,分别指向 x 的前驱和后继,这就是双向链表(doubly linked list)。若只存后继,那就是单向链表(singly linked list),把列表的头(head)和尾(tail)接起来,就会有循环链表(circular list)。
一个双向链表:
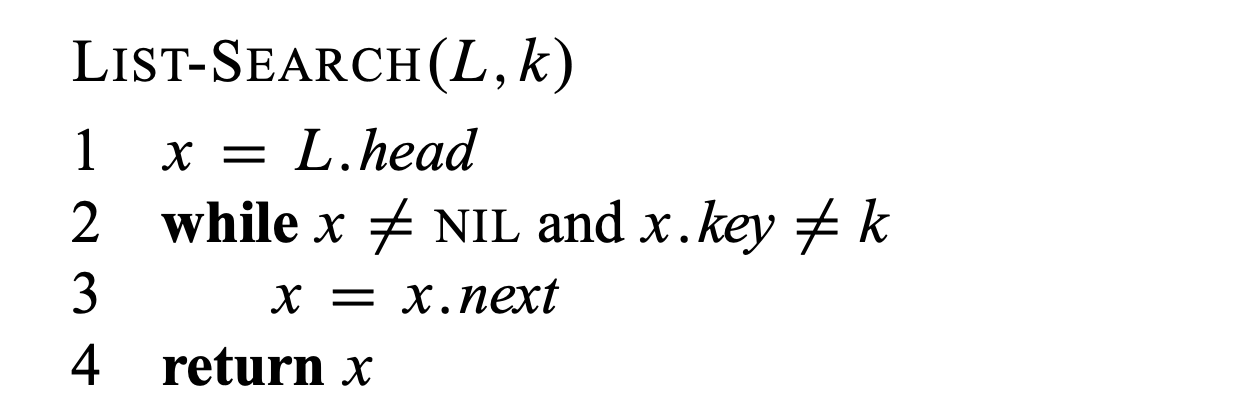
一些支持的操作:
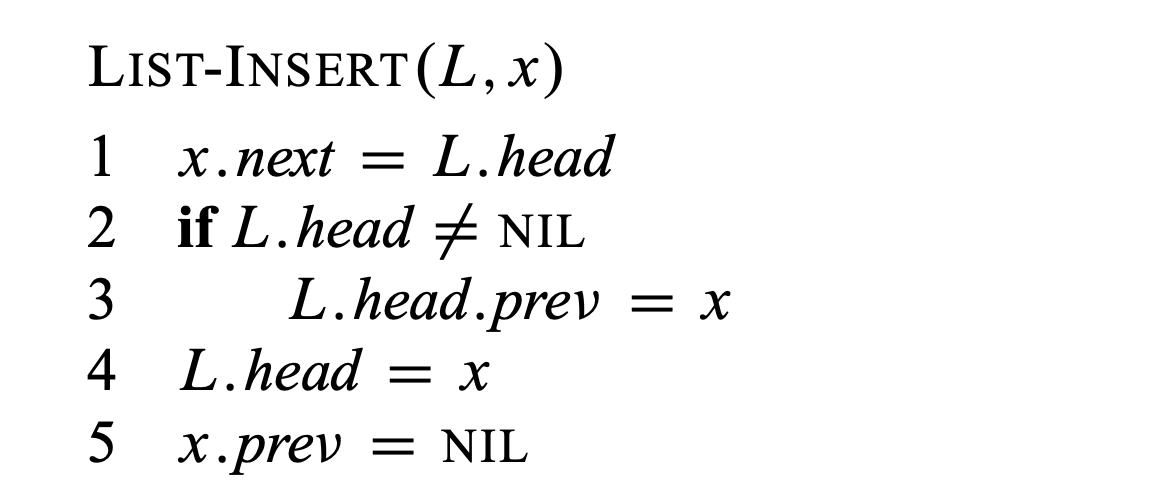
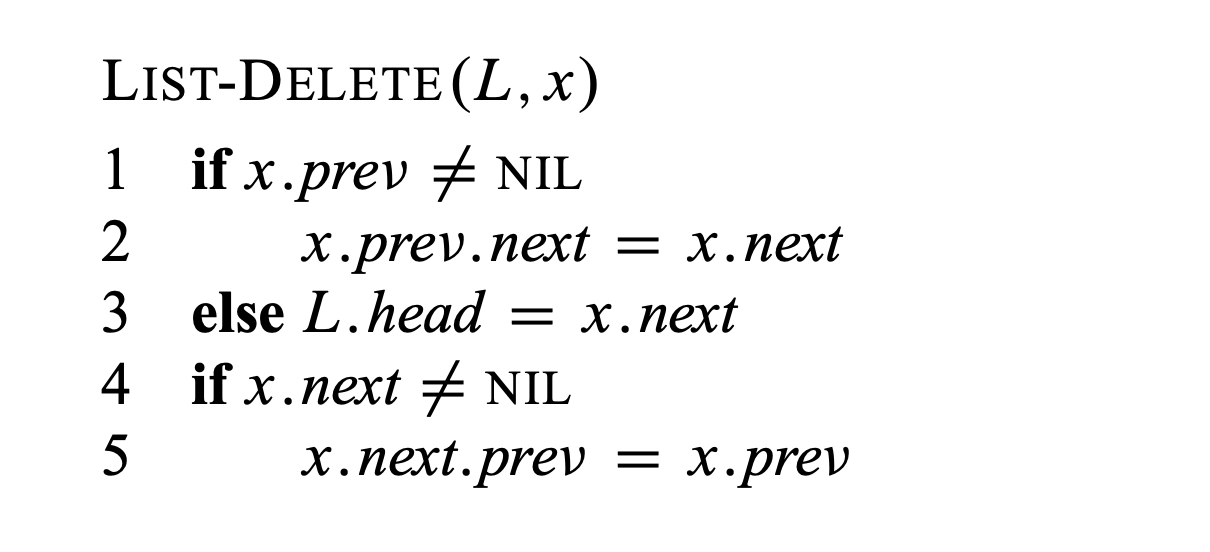
如果我们创建一个 dummy 的 sentinel 元素,记为 L.nil,令它的后继为 head,前驱为 tail,那么就得到一个双向的循环链表,这里上述的代码可以简化,因为一些边界情况不用考虑了。
这里插入和删除一个已知的元素都是 O(1) 的。搜索是 O(n) 的。